סוכני AI מבטיחים לבצע עבורנו משימות שלמות: לחפש מידע, להפעיל כלים, לבדוק מסמכים, לעבוד מול מערכות ארגוניות ולקבל שורה של החלטות בדרך. אבל יש שאלה אחת שלא תמיד מקבלת מספיק תשומת לב: אם הסוכן הצליח לבצע משימה היום, האם הוא יצליח לבצע בדיוק את אותה משימה גם בפעם הבאה?
מחקר של אנשי IBM Research, שפורסם בבלוג של Hugging Face, מצביע על פער משמעותי בין שני דברים שנראים במבט ראשון כמעט זהים: הצלחה ואמינות.
77% הצלחה – אבל רק 53% הצלחה עקבית
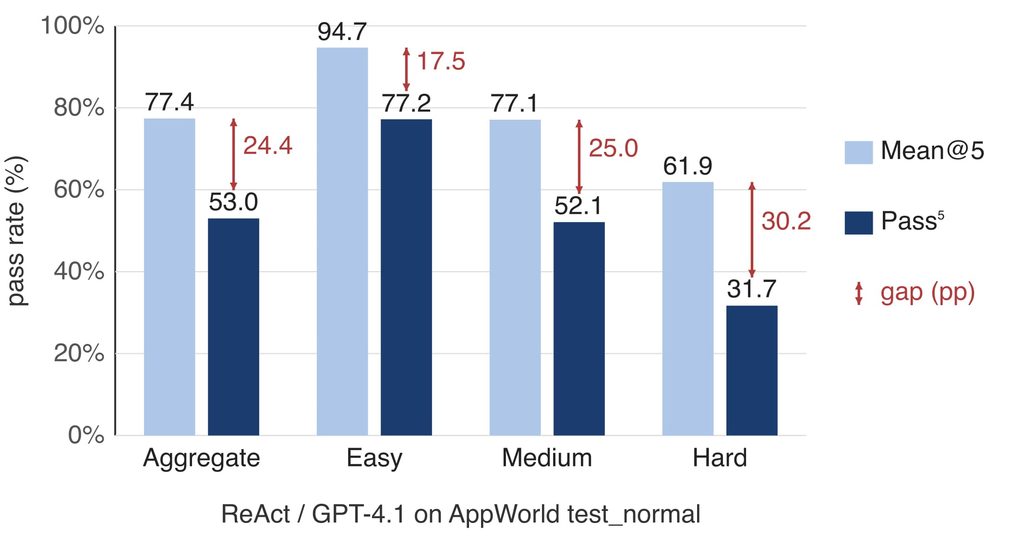
החוקרים בדקו סוכן AI המבוסס על GPT-4.1 על AppWorld, סביבת מבחן המדמה משימות שבהן סוכן צריך לעבוד עם אפליקציות וכלים.
כאשר כל משימה הורצה חמש פעמים, שיעור ההצלחה הממוצע היה 77.4%. נתון שנשמע בהחלט מרשים.
אבל החוקרים בדקו גם בכמה מהמשימות הצליח הסוכן בכל חמש הפעמים ברציפות. התוצאה הייתה 53% בלבד.
כלומר, בחלק לא מבוטל מהמשימות הסוכן ידע להגיע לתוצאה הנכונה, אבל לא עשה זאת באופן עקבי. אותה משימה יכולה להצליח בריצה אחת ולהיכשל בריצה אחרת.
עבור מי שמשתמש ב-AI כדי לנסח טקסט או לחפש רעיונות, חוסר עקביות כזה אולי אינו דרמטי. אבל כאשר סוכן אמור לבדוק עסקה כספית, לעבור על חוזה, לבצע תהליך רכש או להפעיל מערכת ארגונית – השאלה אינה רק אם הוא מסוגל לבצע את המשימה. צריך לדעת אם אפשר לסמוך עליו שיעשה אותה נכון שוב ושוב.
מדוע אותו סוכן מתנהג אחרת?
סוכן AI מבצע בדרך כלל שרשרת של החלטות. הוא מחליט באיזה כלי להשתמש, איזה מידע לחפש, איזה פרמטר להעביר, האם לבצע ניסיון נוסף ומה יהיה הצעד הבא.
בחלק מהשלבים הבחירה ברורה מאוד למודל. באחרים קיימות כמה אפשרויות כמעט שוות.
דווקא בנקודות האלה שינוי קטן יכול לגרום לסוכן לבחור מסלול אחר. וכאשר משימה כוללת עשרות החלטות, גם הבדלים קטנים לאורך הדרך עלולים להצטבר ולהוביל בסופו של דבר לתוצאה אחרת.
החוקרים מדגישים שהבעיה הופיעה גם כאשר המודל הופעל בטמפרטורה 0 – הגדרה שאמורה לצמצם אקראיות. כלומר, גם הגדרה שנראית "דטרמיניסטית" אינה מבטיחה בהכרח שהתהליך כולו יחזור על עצמו בדיוק.
למדוד לא רק הצלחה אלא גם עקביות
כאן נמצא אולי החלק החשוב ביותר במחקר.
רוב מבחני ה-AI מתמקדים בשיעור ההצלחה הממוצע. החוקרים מציעים להוסיף מדד מחמיר יותר: כמה משימות הסוכן מצליח לבצע נכון בכל אחת ממספר ריצות חוזרות.
במילים פשוטות, במקום לבדוק רק כמה פעמים הסוכן מצליח, כדאי לבדוק גם בכמה מהמשימות אפשר לסמוך עליו שיצליח פעם אחר פעם.
זהו הבדל משמעותי במיוחד כאשר מתחילים להעביר סוכני AI מהדגמות מרשימות לתהליכים אמיתיים בארגונים.
ומה IBM מציעה לעשות?
החוקרים מ-IBM Research פיתחו כלי בשם Consistency Analyzer, כחלק מפרויקט הקוד הפתוח ALTK-Evolve.
במקום להריץ שוב ושוב את כל המשימה, הכלי מנסה לזהות בתוך מסלול העבודה של הסוכן את נקודות ההחלטה שבהן הוא אינו יציב – המקומות שבהם שינוי קטן עלול לגרום לו לבחור בדרך אחרת.
לאחר זיהוי הנקודות האלה המערכת מייצרת הנחיות שמנסות להפוך את דרך הפעולה של הסוכן לעקבית יותר.
לפי התוצאות שפרסמו החוקרים, לאחר הוספת ההנחיות עלה שיעור המשימות שבהן הסוכן הצליח בכל חמש הריצות מ-53% ל-69%. במקביל, שיעור ההצלחה הממוצע לא נפגע ואף עלה מ-77.4% ל-81%.
חשוב לסייג: מדובר בשיטה ובכלי שפיתחו החוקרים עצמם, ולכן נכון להתייחס לתוצאות כאל ממצאים שהם מדווחים על המערכת שלהם, ולא כאל אימות עצמאי של הפתרון.
מבחן חדש לסוכני AI
הדיון סביב סוכני AI מתמקד בדרך כלל במה שהם מסוגלים לעשות. ככל שהם נכנסים לתהליכים עסקיים אמיתיים, העקביות שלהם מקבלת חשיבות גדולה יותר.
לא מספיק שסוכן יצליח פעם אחת בהדגמה.
מערכת שאנחנו באמת רוצים להפקיד בידיה עבודה צריכה להיות לא רק חכמה ומסוגלת – אלא גם צפויה ועקבית. ככל שסוכני AI מקבלים יותר אחריות בתהליכים אמיתיים, היכולת לחזור על אותה משימה ולקבל שוב תוצאה נכונה הופכת לחלק בלתי נפרד מהאמינות שלהם.
מקור: IBM Research, פורסם ב-Hugging Face, 15 בספטמבר 2026
לינק לכתבה המקורית:
Your Agent Aced the Task. Will It Do It Again?